姿態估測
姿態估測會將物件偵測結果轉換為機器人可使用的位置與方向資訊。
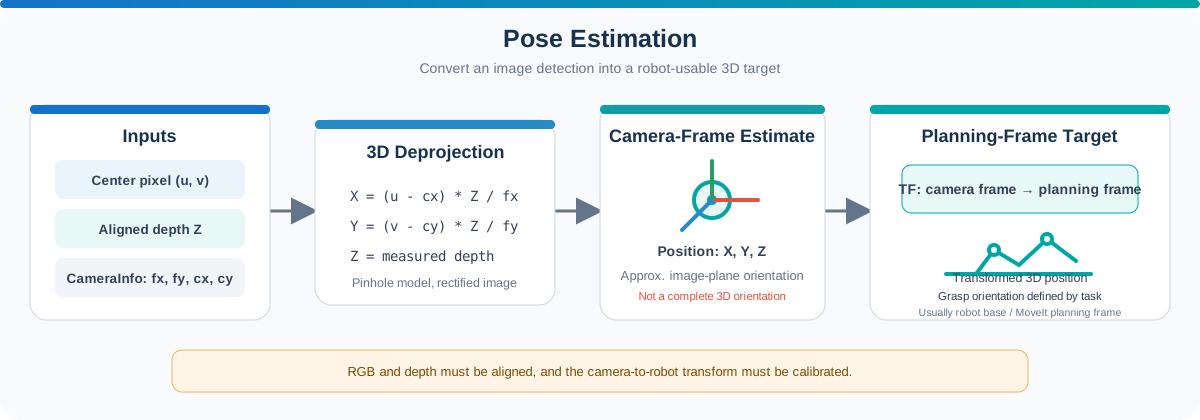
物件感知可能只會將目標定位在影像像素座標 (u, v),但機械手臂是在 3D 座標系中運作。為了串接這兩種表示方式,系統需要將偵測結果與深度資料、相機校正資訊以及座標轉換結合。
在機械手臂的工作流程中,姿態估測主要回答以下問題:
- 物件距離相機多遠?
- 物件在 Camera Frame 中的 3D 位置為何?
- 物件的方向為何?
- 物件相對於 Robot Base 的位置為何?
產生的 Pose 會作為後續運動規劃的目標。
在機械手臂工作流程中的角色
典型的姿態估測流程如下:
2D detection → Depth lookup → 3D position in camera frame → TF transformation → Pose in robot base frame
輸入通常包含:
- RGB 影像中的目標中心點或關鍵點
- 對齊後的深度影像
- 相機內參
- 相機與機器人之間的座標轉換
輸出通常會以與特定坐標系與 Timestamp 關聯的 3D 位置與方向表示,例如使用 geometry_msgs/msg/PoseStamped。
座標系
機械手臂系統會使用多個座標系,也稱為 Frame。
| Frame | 說明 |
|---|---|
| Image Frame | 2D 像素位置,例如 (u, v) |
| Camera Frame | 相對於相機量測的 3D 位置 |
| Robot Base Frame | 相對於機器人底座量測的 3D 位置 |
| End-Effector Frame | Gripper 或 Tool 的位置與方向 |
只有在已知所屬 Frame 的情況下,位置資訊才有意義。例如,Camera Frame 中的 (0.3, 0.1, 0.6),並不代表 Robot Base Frame 中相同數值的位置。
ROS 2 使用 TF 維護這些 Frame 之間的關係。
從像素座標轉換為 3D 位置
RGB 影像可以提供物件的水平與垂直像素座標,但本身無法提供距離資訊。RGB-D 相機則會為可用的像素提供對應的深度值。
對於偵測到的中心像素 (u, v),姿態估測流程會:
- 讀取中心點或其周圍的深度值。
- 確認深度資料有效,且位於預期範圍內。
- 使用相機內參將該像素投影至 3D 空間。
對於使用針孔相機模型的 Rectified Image,3D 位置可依下式計算:
Z = depth
X = (u - cx) × Z / fx
Y = (v - cy) × Z / fy
其中:
fx和fy為以像素為單位的焦距。cx和cy為 Principal Point 座標。Z為量測到的深度。X,Y,Z共同組成物件在 Camera Frame 中的位置。
這些相機內參由相機校正取得,在 ROS 2 中通常透過 sensor_msgs/msg/CameraInfo 發布。
RGB 與 Depth 對齊
在使用 RGB 像素座標讀取深度值之前,RGB 與 Depth 影像必須描述相同的視角。
當 Depth 已對齊至 RGB 影像時,像素 (u, v) 在兩張影像中會對應到場景中的相同位置。若未完成對齊,直接使用 RGB 座標讀取 Depth 影像,可能會得到錯誤距離,甚至讀取到鄰近物件。
部分 Camera Driver 會直接提供 Aligned Depth Topic。若沒有提供,則需要利用 RGB 與 Depth Sensor 之間的校正資訊進行 Registration。
可靠的深度取樣
單一像素的深度值可能缺失或受到雜訊影響,尤其是在物件邊緣、反光表面或超出感測器有效範圍的區域。
與其只依賴單一像素,系統可以:
- 在偵測中心點周圍取樣一個小範圍。
- 忽略 0、無效值或超出有效範圍的數值。
- 對剩餘的有效深度樣本取中位數。
- 當有效樣本過少時,捨棄該偵測結果。
中位數有助於降低少數異常深度值的影響。取樣範圍應維持足夠小,以避免同時混入目標物件與背景。
方向估測
完整的 Object Pose 同時包含 Position 與 Orientation。
適合的方向估測方法會依物件與任務而異:
- 矩形輪廓可提供近似的影像平面旋轉角度。
- 關鍵點或幾何特徵可用來估算更完整的方向資訊。
- Fiducial Marker 可提供已知的 6D Pose。
- AI姿態估測模型可針對更複雜的物件估算方向。
在彩色方塊範例中,系統會利用輪廓估算近似的 2D Yaw。這可用來說明方塊在影像中的旋轉方向,但並不是完整的 3D Orientation。
對於實際的抓取任務,系統可能還需要考慮:
- 物件表面法向量
- 夾爪接近方向
- 工具幾何參數與抓取偏移量
- 物體對稱性
- 機器人的機構限制
相機至機器人座標轉換
透過 RGB-D 資料計算出的物件位置,最初會表示在 Camera Frame 中。在進行運動規劃之前,必須將其轉換到 Robot 規劃系統中所使用的 Frame,通常是 Robot Base Frame 或 Planning Frame。
因此,系統必須已知這些 Frame 之間的關係:
Robot base frame
      ↕ TF
Camera frame
      ↓
Detected object pose
這個關係會透過 Camera-to-Robot Calibration 決定,並透過 TF 發布。之後系統即可將偵測到的 Object Pose 從 Camera Frame 轉換至 Robot Base Frame。
常見的相機配置有兩種:
- Eye-to-Hand: 相機固定於工作空間中,相對於 Robot Base 的 Transform 為固定值。
- Eye-in-Hand: 相機安裝於機器人上,其 Pose 會隨 End Effector 移動,並透過機器人的 TF Tree 解析。
即使 2D Detection 與 Depth Value 看起來都正確,只要 Camera Transform 不準確,就可能造成偵測位置與機器人實際目標之間出現固定偏差。
範例:彩色方塊位置估算
Robotic Suite 範例將 Color 偵測、Aligned Depth 與相機參數結合使用。
針對每個偵測到的方塊,Node 會:
- 在 RGB 影像中找出方塊中心點。
- 讀取中心點附近的有效深度樣本。
- 將像素座標與深度轉換為 Camera Frame 中的 3D 位置。
- 從方塊輪廓估算近似的 Image-Plane Yaw。
- 顯示或發布結果供使用者確認。
此 Sample 示範姿態估測中與相機端相關的部分。若要將結果套用至實體機器手臂,應用程式還必須建立 Camera-to-Robot Transform,並將 Pose 轉換至 Robot Base Frame。
相關教學範例請參考 Color Block Detection & Position Estimation 。
驗證估測姿態
在將 Pose 作為 Motion Planning Target 之前,應確認:
- RGB 與 Depth 影像已完成對齊與同步。
- Depth Unit 的解讀正確。
- 相機參數與目前使用的影像解析度一致。
- Source Frame 與 Timestamp 正確。
- 所需的 TF Transform 可以取得。
- 轉換後的目標位於機器人的 Workspace 內。
- Position 與 Orientation 在連續數個 Frame 中保持穩定。
如果估算位置不正確,建議依序檢查 Pipeline:Detection Center、Depth Value、Camera Intrinsics、Depth Alignment,最後再檢查 Camera-to-Robot Transform。
重點整理
- 在此 RGB-D 工作流程中,2D Detection 會與 Depth 結合以取得 3D Position。
- Camera Intrinsics 會將 Image Pixel 轉換成 Camera Frame 中的 Point。
- RGB 與 Depth Alignment 是正確讀取深度值的必要條件。
- TF 會將 Camera Frame 中的 Pose 轉換至 Robot Base Frame。
- Image-Plane Yaw 僅為近似方向,並不是完整的 6D Pose。
- 在允許機器人移動之前,必須先驗證 Pose 品質。
下一步: 使用目標 Pose,在運動規劃中產生安全的機器人運動軌跡。