下載 Qualcomm AI Hub 模型
本範例將示範如何利用 Qualcomm AI Hub 下載並匯出專為 QCS6490 晶片量身打造的 YOLO 物件偵測模型。
概述
Qualcomm AI Hub 是一個集中式模型儲存庫與最佳化服務,旨在簡化將 AI 模型部署到 Qualcomm 邊緣裝置的流程。
- 預先優化 AI 模型:可存取專為 Qualcomm 架構特別調校的豐富模型庫(例如 YOLO、MobileNet 和 ResNet)。
- 硬體加速 (NPU/GPU/CPU):輕鬆將模型編譯並量化為 ONNX、TFLite 或 Qualcomm AI Runtime 等格式,充分發揮晶片上 AI 加速器的效能。
- 縮短上市時間:降低嵌入式開發人員手動進行模型量化與硬體特定核心調整的複雜度。
系統需求與元件
| 元件 | 規格 |
|---|---|
| 平台 | ASR-D501 (Qualcomm QCS6490) |
| 作業系統映像檔 | ASRD501A1-Ubuntu24.04-x07_v1.0.0 |
| 模型 | YOLOv8-Detection (從 Qualcomm AI Hub Models 取得) |
操作流程
- 步驟一:從 Qualcomm AI Hub 選擇相容於 QCS6490 的模型
- 步驟二:準備獨立的 Python 環境
- 步驟三:虛擬環境設定(安裝模型套件)
- 步驟四:Qualcomm AI Hub Workbench 驗證
- 步驟五:匯出相容於 QCS6490 的模型
步驟一:從 Qualcomm AI Hub 選擇相容於 QCS6490 的模型
開啟 Qualcomm AI Hub 模型頁面 ↗,選擇 Qualcomm Dragonwing™ QCS6490 進行篩選。
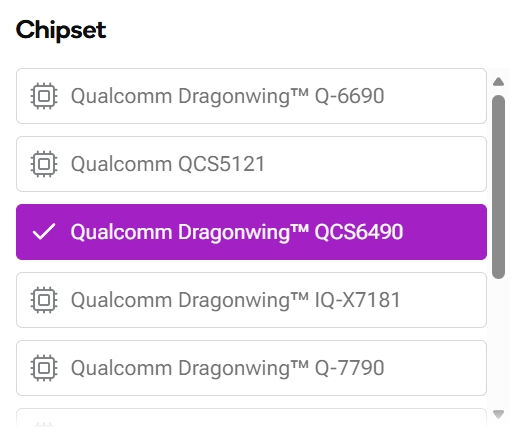
選擇您要在裝置上執行的模型。在此範例中,我們選擇 YOLOv8-Detection ↗。
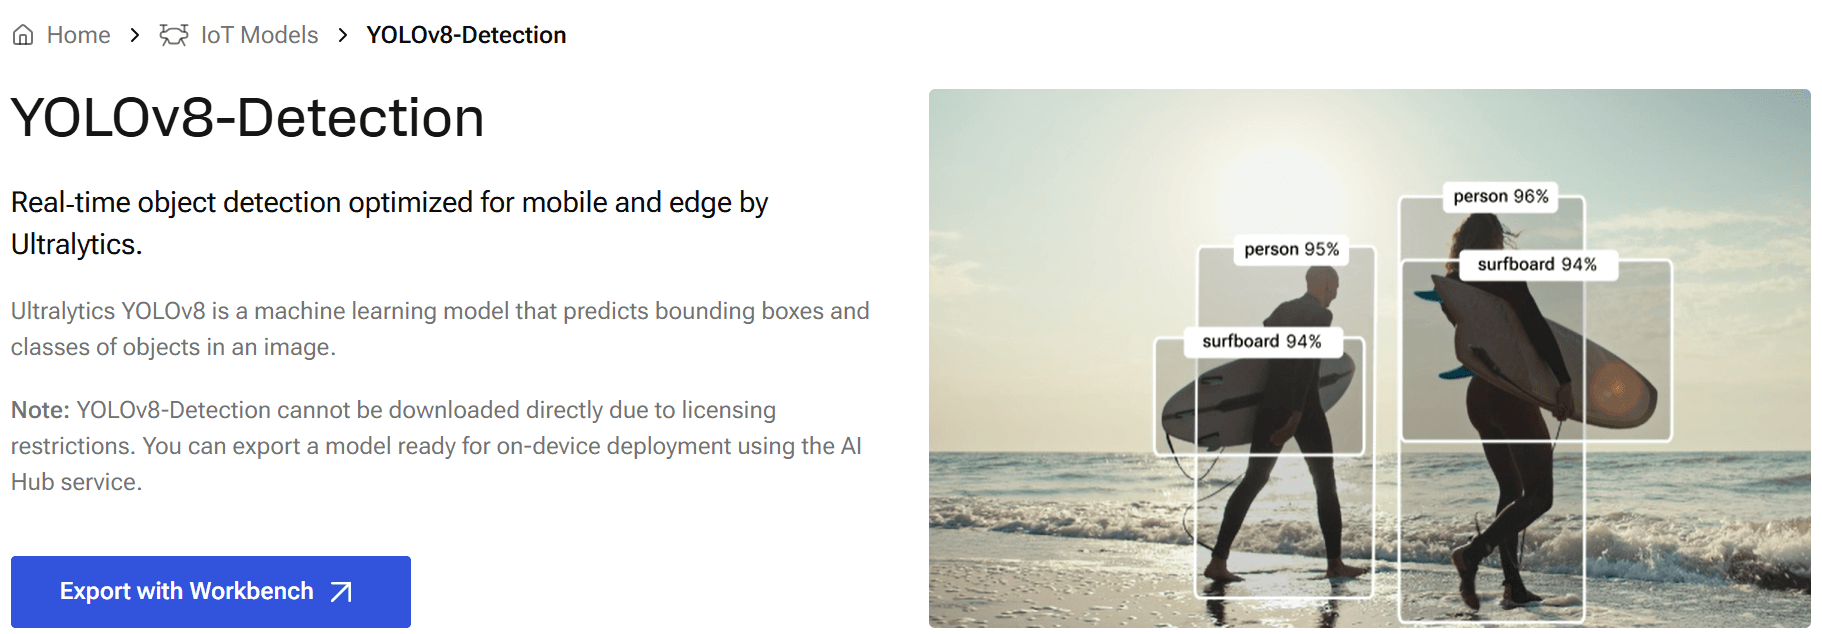
如需匯出的詳細操作資訊,請參閱 YOLOv8-Detection 原始程式碼與說明文件 (GitHub) ↗.
步驟二:準備獨立的 Python 環境
首先,先確認您的 Python 版本受到所選 qai-hub-models 發行版本的支援。
您可以在 GitHub 頁面上檢查支援的 Python 版本。
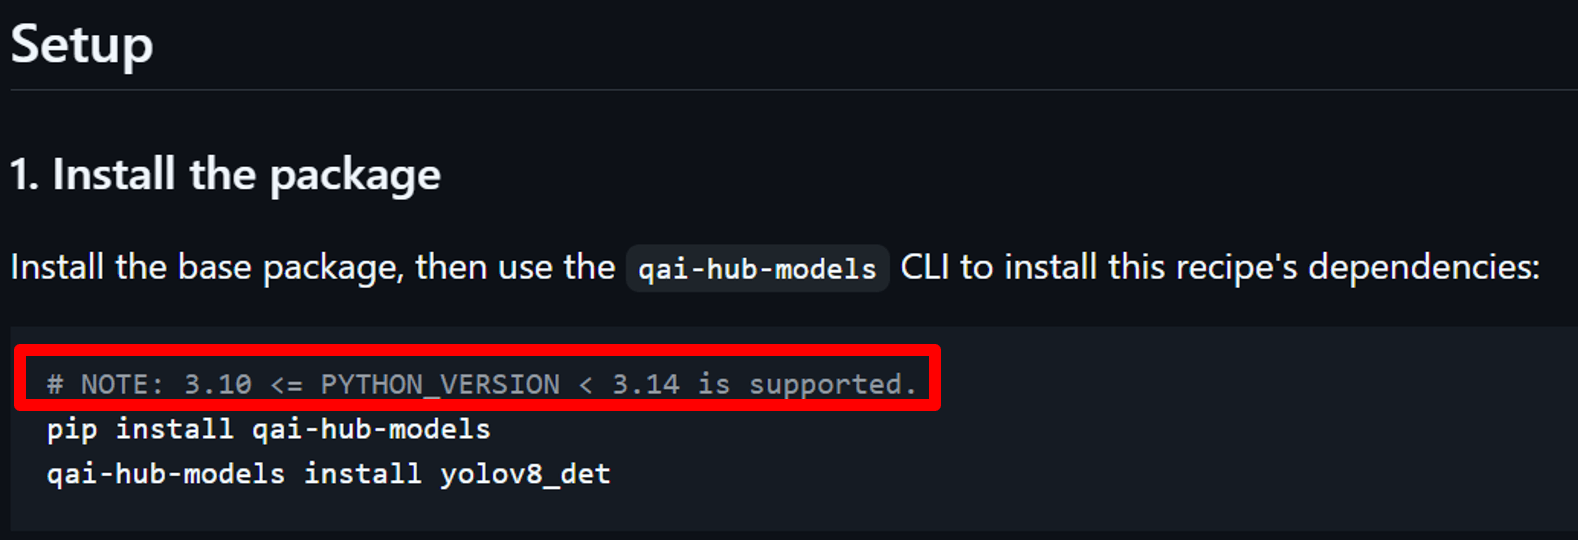
建立並啟用 Python 虛擬環境,使相依性與系統 Python 保持隔離。
將 <venv_name> 替換為您想要的環境名稱:
sudo apt update
sudo apt install python3-venv
python3 -m venv <venv_name>
source <venv_name>/bin/activate
步驟三:虛擬環境設定(安裝模型套件)
安裝 Qualcomm AI Hub Models 和 YOLOv8-Detection 模型:
pip install qai-hub-models==0.61.0
qai-hub-models install yolov8_det
在匯出之前,使用 W8A8 量化執行展示結果:
python3 -m qai_hub_models.models.yolov8_det.demo --quantize w8a8
展示結果如下所示。
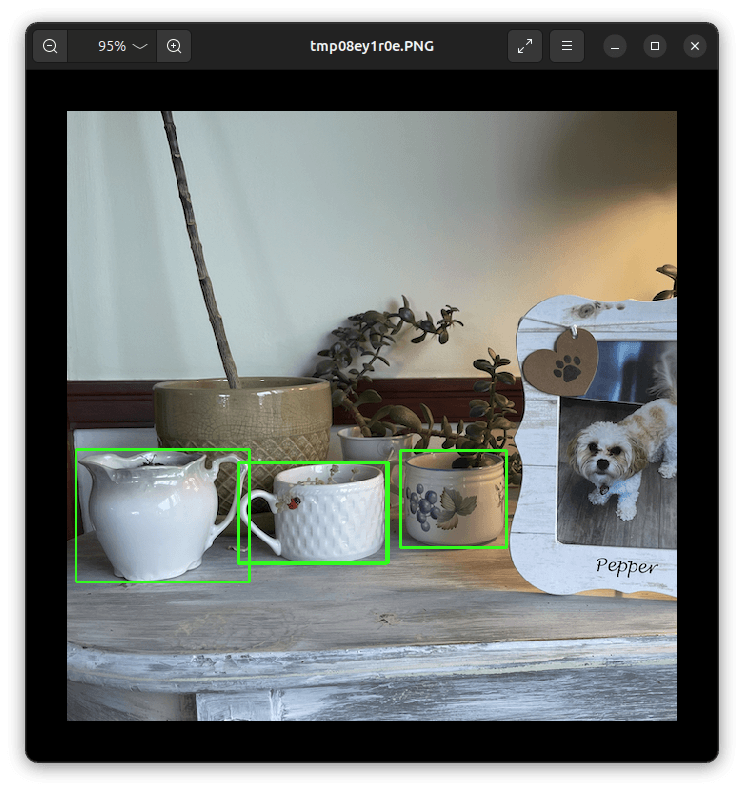
成功的展示可確認在匯出之前,模型及其相依性皆已正確安裝。
步驟四:Qualcomm AI Hub Workbench 驗證
建立 Qualcomm AI Hub Workbench 帳戶 ↗,並從 Account → Settings → API Token 取得您的 API 金鑰。
設定從 Qualcomm AI Hub Workbench 帳戶中取得的 <API_TOKEN>:
qai-hub configure --api_token <API_TOKEN>
注意:請將 <API_TOKEN> 視為機密資訊。切勿公開分享、張貼至網路或包含在任何截圖中。
步驟五:匯出相容於 QCS6490 的模型
在匯出模型之前,您可以使用以下指令列出所選模型支援的選項:
qai-hub-models export yolov8_det --help
匯出 W8A8 量化後的 TensorFlow Lite (TFLite) 模型:
qai-hub-models export yolov8_det \
  --target-runtime tflite \
  --quantize w8a8 \
  --chipset qcs6490
在此範例中,匯出流程為:
| 步驟 | 階段 | 動作與格式 | 說明 |
|---|---|---|---|
| 01 | 初始編譯 | PyTorch (.pt) → ONNX | 將原始的 PyTorch 模型轉換為 ONNX 格式。 |
| 02 | 量化 | W8A8 | 套用 W8A8 量化以壓縮模型權重與活化值。 |
| 03 | 目標編譯 | 量化的 ONNX → TFLite | 將量化後的模型編譯為目標執行階段格式 (.tflite)。 |
| 04 | 效能分析 | 設備基準測試 | 在實體裝置上測量延遲與記憶體消耗。 |
| 05 | 推論 | 範例驗證 | 使用範例輸入執行測試推論。 |
匯出作業及其個別階段可在 Qualcomm AI Hub Workbench 中檢視。
Qualcomm AI Hub Workbench 畫面可用來檢查提交的模型匯出作業與階段結果。
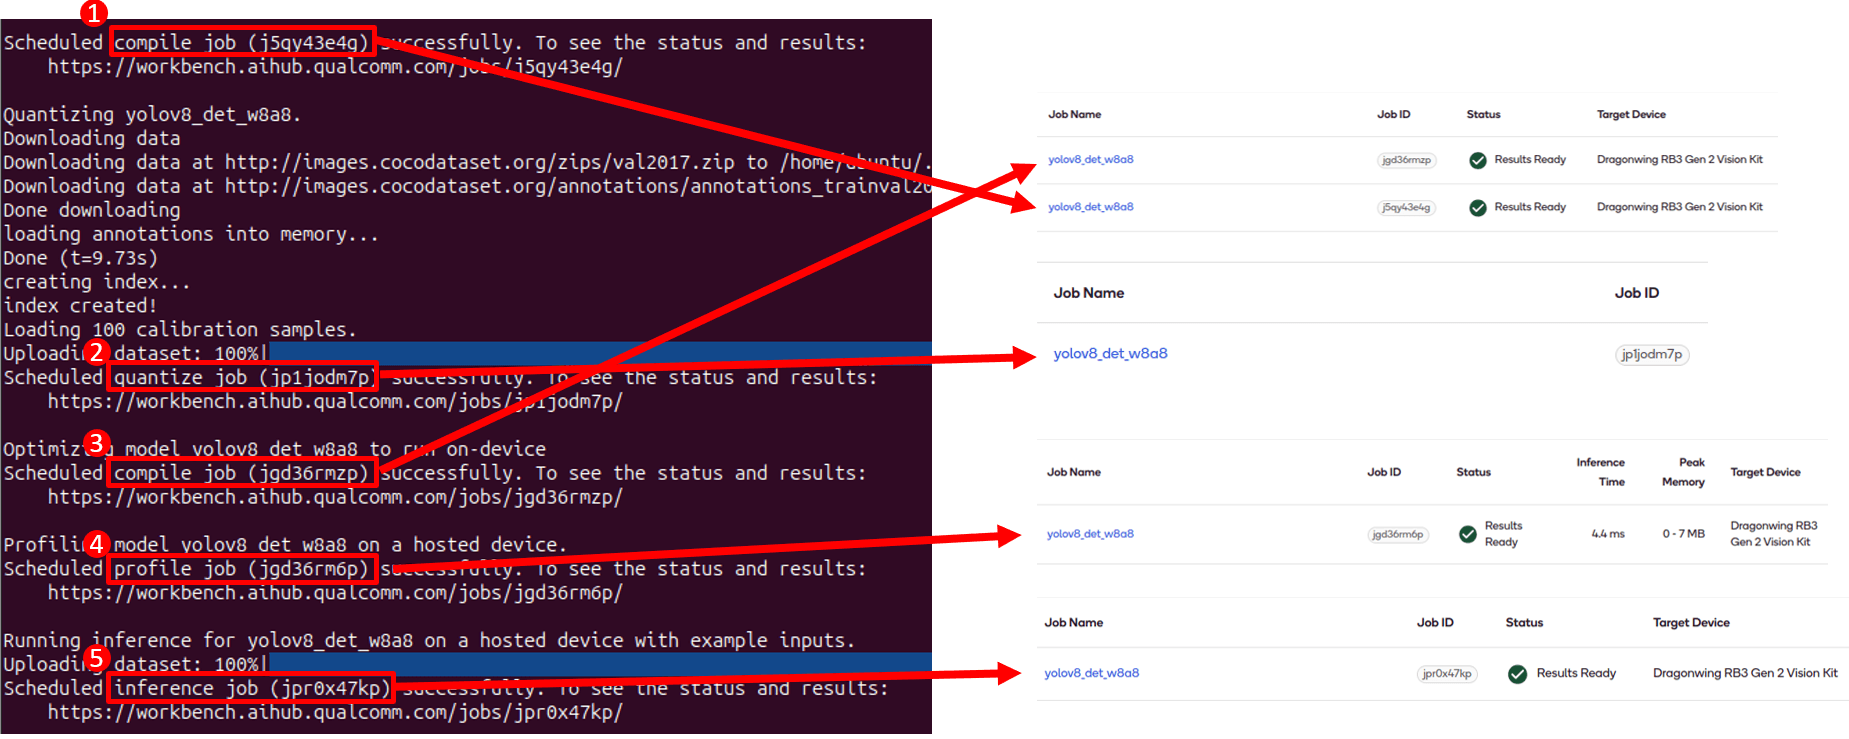
當所有流程完成後,
輸出結果將存於 ./export_assets/yolov8_det-tflite-w8a8 資料夾中。
模型匯出完成後,您可以安全地離開虛擬環境:
deactivate